KI-Avatar-Training: Wann Video-Personas helfen
Marcelo Pereira10 Min. Lesezeit
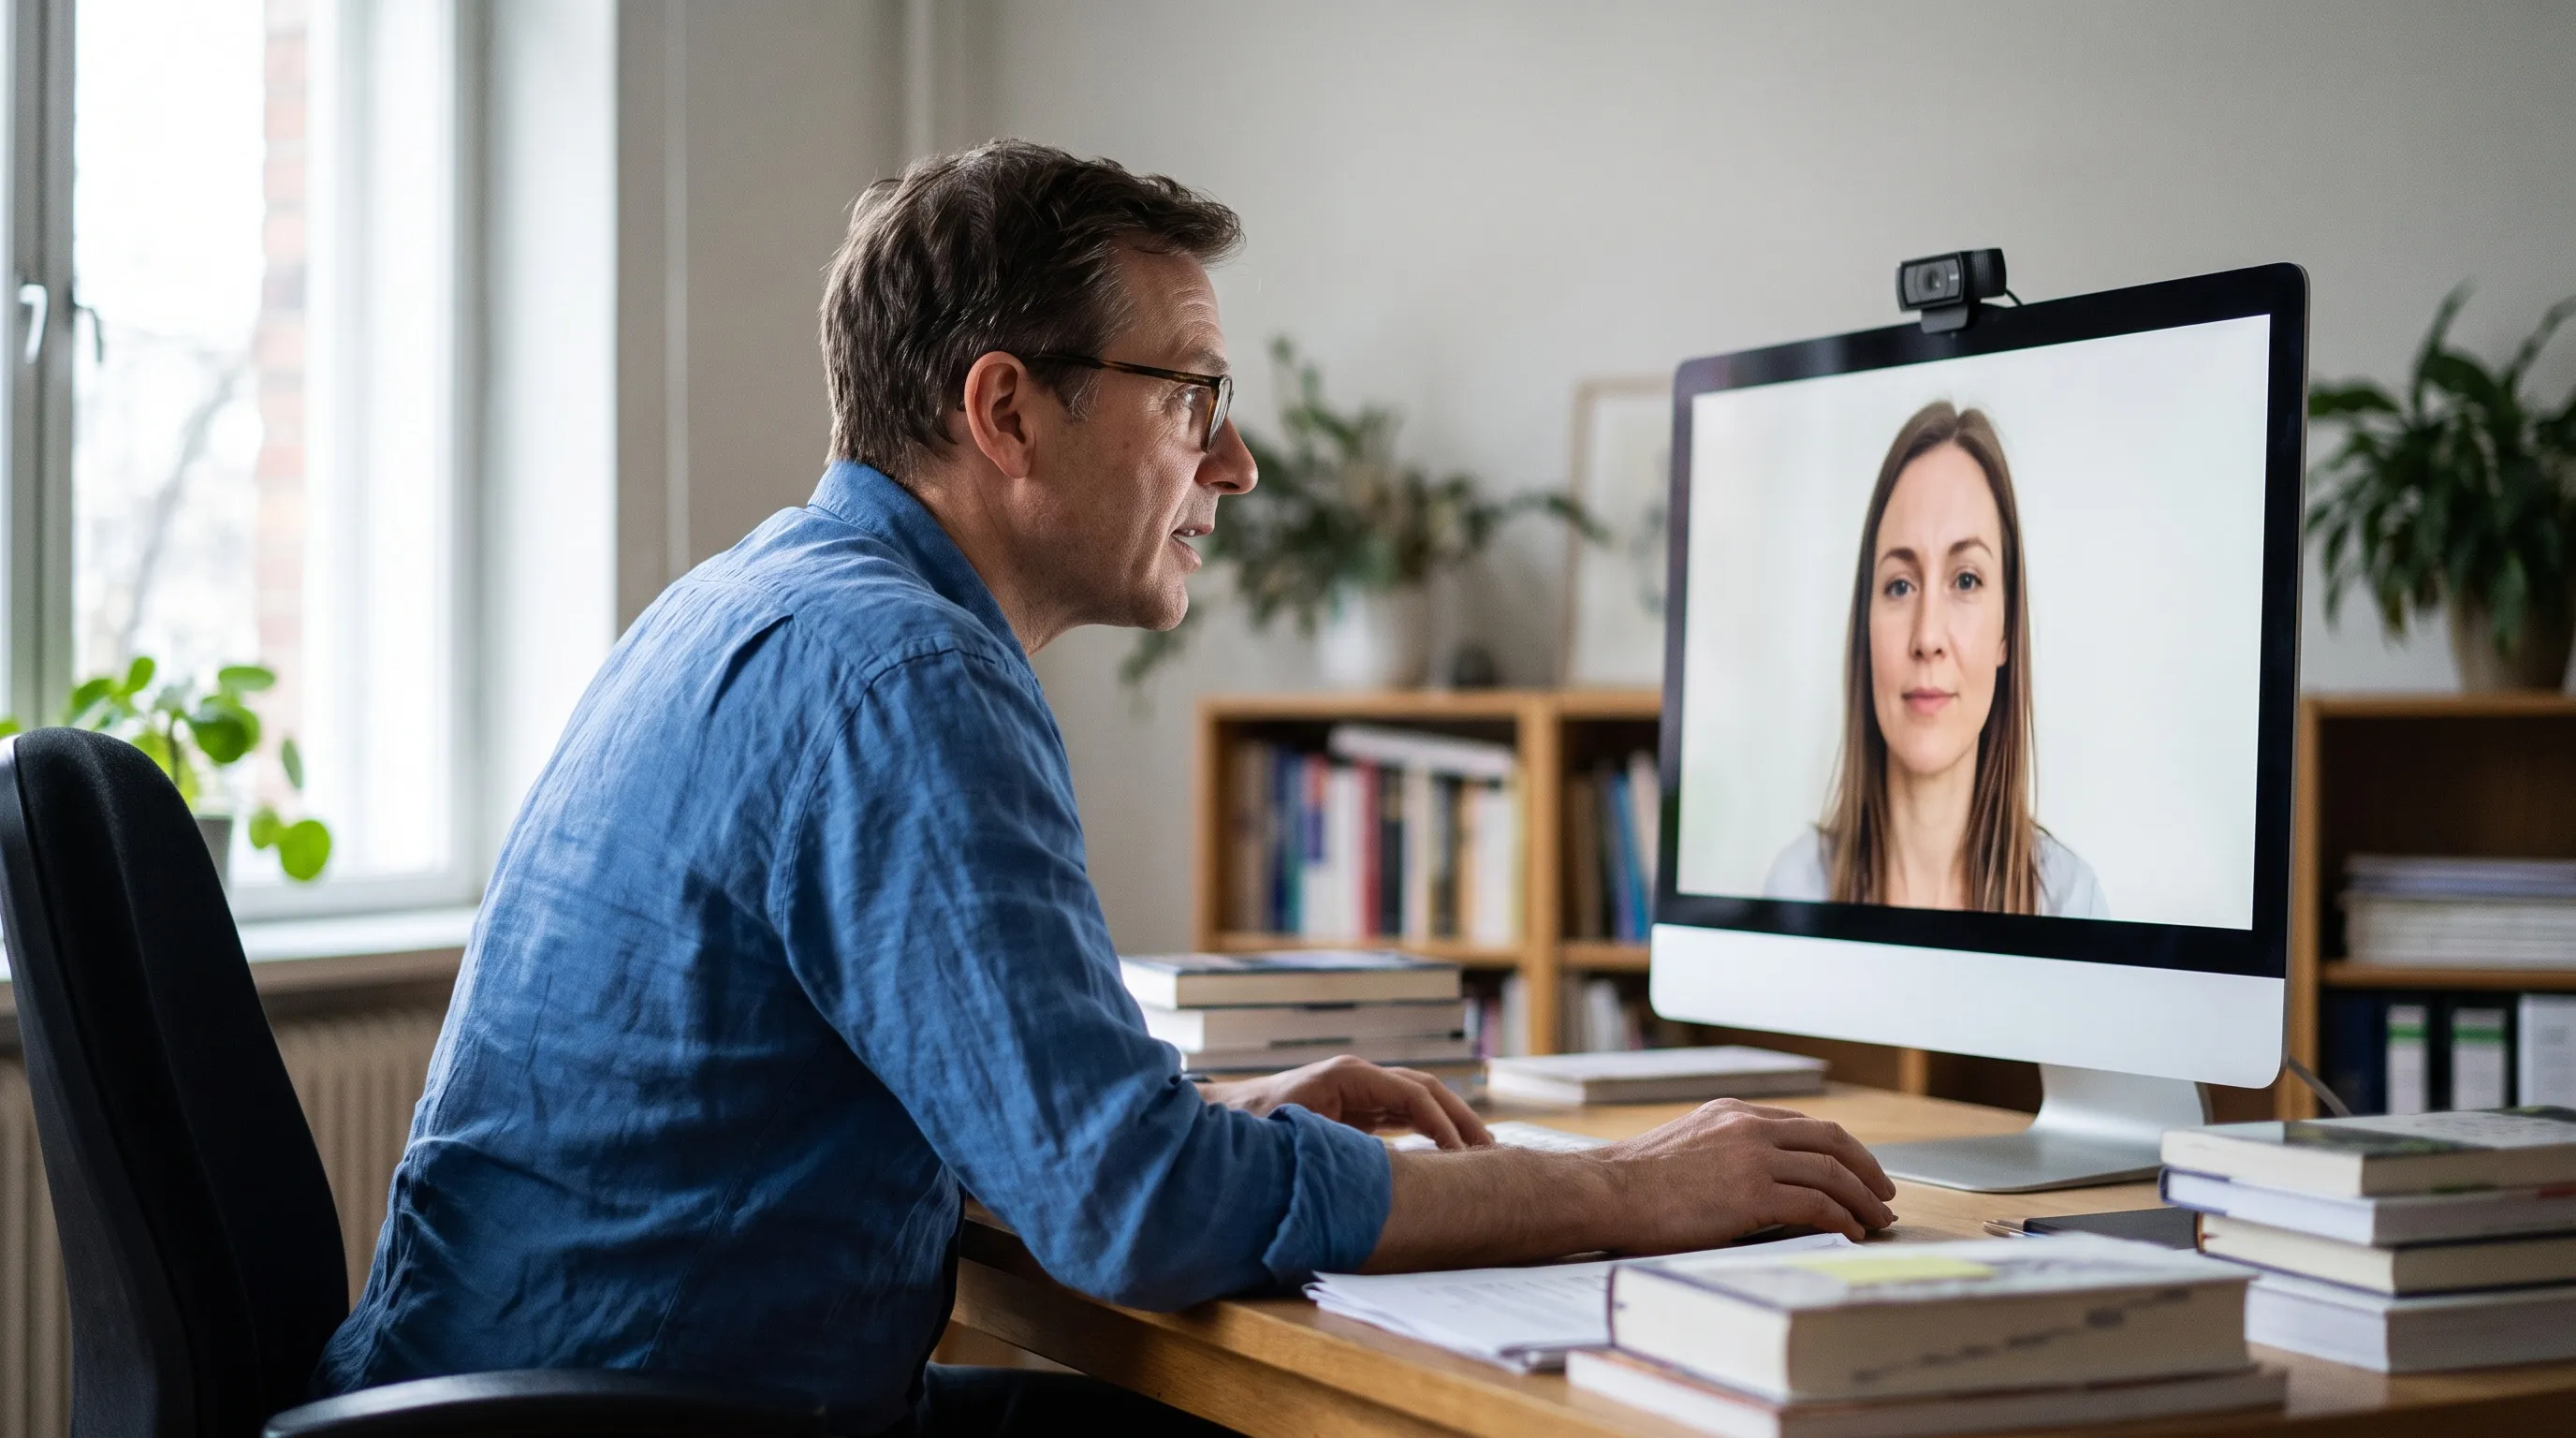
KI-Avatar-Training ist Rollenspiel mit einer Persona, die Sie sehen und hören können: eine Videofigur in Echtzeit, die einen Kunden, einen Patienten oder einen Bewerber spielt, während Sie laut mit ihr sprechen. Das Gesicht bringt etwas, wenn der Job selbst von Angesicht zu Angesicht stattfindet. Findet der Job am Telefon statt, ist reines Sprachtraining näher an der Realität und meist die bessere Wahl.
Dieser Leitfaden richtet sich an Trainingsverantwortliche, die entscheiden, ob sie Video-Personas für ihre Teams einschalten. Sie bekommen eine Definition, die Rollen, in denen ein Gesicht den Trainingswert erhöht und in denen nicht, einen Blick auf die Forschung zu sozialer Präsenz, die Kostenseite und eine Entscheidungstabelle nach Rolle.
Zwei Dinge, die „KI-Avatar-Training“ heißen
Der Begriff deckt zwei Produkte ab, die nichts miteinander zu tun haben, und Suchergebnisse mischen sie.
Das erste ist die Avatar-Videoerzeugung für E-Learning: Software, die ein Skript in ein Video verwandelt, in dem ein Sprecher es vorliest. Nützlich für Compliance-Module und Produkterklärungen. Es ist Inhalt, keine Übung. Niemand antwortet, und um diese Produkte geht es in diesem Artikel nicht.
Das zweite ist Rollenspiel mit Avatar: eine Persona mit Gesicht, die in Echtzeit auf das reagiert, was Sie sagen, in einem Gespräch, das Sie führen. Der Lernende spricht, die Persona antwortet, der Gesichtsausdruck verändert sich mit dem Gespräch. Darum geht es hier. Für die Grundlagen der Übung selbst lesen Sie zuerst was KI-Rollenspiel-Training ist.
Was ein Gesicht hinzufügt und was nicht
Rollenspiel trainiert Verhalten unter Bedingungen, die der echten Aufgabe nahekommen. Die Frage bei jedem zusätzlichen Realismus ist einfach: Enthält die echte Aufgabe dieses Element? Wenn der Lernende einer Person über eine Theke, einen Schreibtisch oder ein Krankenbett hinweg gegenübersitzt, gehört das Gesicht dieser Person zum Job. Wenn der Lernende eine Stimme über ein Headset hört, nicht.
| Element der echten Aufgabe | Reines Sprachtraining deckt es ab | Video-Persona fügt es hinzu |
|---|---|---|
| Worte unter Druck finden | Ja | Keine Änderung |
| Ton, Tempo und Stille | Ja | Keine Änderung |
| Beobachtet werden, während man spricht | Teilweise | Ja, die Persona schaut zurück |
| Ein Stirnrunzeln oder einen abgewandten Blick lesen | Nein | Ja, im Rahmen dessen, was der Avatar darstellt |
| Blickkontakt halten, während man nachdenkt | Nein | Ja |
| Ein Gespräch per Telefon oder Headset führen | Ja, genau das | Fügt etwas hinzu, das der Job nicht hat |
Die letzte Zeile zählt. Übung sollte nicht auf eine Art anspruchsvoller sein, die der Job nicht ist. Ein Callcenter-Agent, der mit einem Gesicht übt, lernt, mit Blickkontakt umzugehen, den er nie brauchen wird, während die Fähigkeit, die er braucht, Frustration allein an der Stimme zu hören, keine zusätzliche Hilfe bekommt.
Rollen, in denen das Gesicht den Trainingswert erhöht
Verkaufsfläche im Einzelhandel
Ein Kunde kommt auf den Verkäufer zu, fragt nach einem Produkt und beobachtet dessen Reaktion. Der Verkäufer begrüßt, liest, ob der Kunde Hilfe oder Raum will, und hält ein Gespräch am Laufen, während ihn jemand ansieht. Mit einer Persona zu üben, die zurückschaut, kommt dem näher als Üben mit Audio. Ein Plan für Verkaufstraining im Einzelhandel mit Begrüßung und Bedarfsermittlung auf der Fläche passt dazu.
Patientengespräche
Ärzte und Pflegekräfte überbringen Nachrichten, erklären Optionen und prüfen das Verständnis, während sie das Gesicht eines Patienten beobachten. Innehalten, wenn der Patient verloren wirkt, ist eine sichtbare Fähigkeit. In einer reinen Sprachsitzung muss der Lernende das aus der Stille ableiten. Mit einer Video-Persona gibt es etwas zu sehen.
Gespräche im Personalbereich
Ein Interviewer, eine Führungskraft, die schwieriges Feedback gibt, oder jemand, der ein Jahresgespräch führt, sitzt einer Person gegenüber. Der Lernende lernt, eine Frage offen zu halten, während die andere Person nachdenkt, statt die Pause zu füllen. Ein Gesicht, das wartet, trainiert das besser als eine Stimme, die wartet.
Hotellerie und Rezeption
Check-in, eine Beschwerde an der Rezeption, ein Gast, der etwas verlangt, das das Hotel nicht bieten kann. Das sind Begegnungen von Angesicht zu Angesicht, bei denen ein freundlicher Ausdruck unter Druck Teil des Service ist.
Rollen, in denen Audio der echte Job ist
Telefonverkauf, eingehender Support, telefonische Terminvereinbarung, Inkasso, technische Hotlines. In all diesen Fällen sehen sich Agent und Kunde nie. Die Fähigkeit liegt in der Stimme: Gereiztheit früh hören, Tempo, Wortwahl, Stille nutzen. Reines Sprachtraining bildet den Job ab. Eine Video-Persona fügt einen Kanal hinzu, den der Agent bei der Arbeit nicht hat.
Es gibt ein zweites Argument für reine Sprache in diesen Rollen. Die fünf Schritte im Umgang mit einem verärgerten Kunden hängen davon ab, Signale im Ton zu hören. Wer mit einem Gesicht übt, verlässt sich womöglich auf visuelle Signale und trainiert das Zuhören, das der Job verlangt, zu wenig.
Was die Forschung zu sozialer Präsenz sagt
Soziale Präsenz ist das Gefühl, während einer vermittelten Interaktion mit einer anderen Person zusammen zu sein. Der Begriff stammt aus einem Buch von 1976, „The Social Psychology of Telecommunications“, von John Short, Ederyn Williams und Bruce Christie. Sie behandelten soziale Präsenz als Eigenschaft des Mediums: Video trägt mehr davon als Audio, Audio mehr als Text. Ein reicheres Medium fühlt sich mehr an, als wäre man im selben Raum.
Frank Biocca, Chad Harms und Judee Burgoon überprüften das Konzept in einer Arbeit von 2003 und argumentierten, dass Präsenz nicht nur eine Eigenschaft des Kanals ist, sondern der Interaktion: Sie steigt, wenn die andere Seite Sie zu bemerken scheint und auf Sie reagiert. Für Rollenspiel ist das der wichtige Punkt. Eine Persona, die auf das reagiert, was Sie sagen, erzeugt Präsenz, ob sie ein Gesicht hat oder nicht. Das Gesicht steigert sie weiter, aber eine reagierende Stimme leistet schon einen großen Teil der Arbeit.
Eine Warnung aus der Lernforschung: Richard Mayers Arbeit zum multimedialen Lernen enthält, was er das Bildprinzip (image principle) nennt. Über seine Studien hinweg verbesserte das Einblenden des Sprechers auf dem Bildschirm das Lernen aus einer Erklärung nicht zuverlässig. Der Kontext ist Unterricht, nicht Rollenspiel, also entscheidet das die Frage für Gesprächstraining nicht. Es warnt aber davor, anzunehmen, dass ein Gesicht immer hilft.
Zusammengenommen: Nutzen Sie ein Gesicht, wenn der Job eines hat, weil der Lernende dann übt, es zu lesen und ihm standzuhalten. Erwarten Sie nicht, dass es eine Telefonfähigkeit verbessert.
Kosten und Bandbreite
Eine Video-Persona in Echtzeit kostet im Betrieb mehr als eine Sprachsitzung, weil die Videoerzeugung auf der Sprache aufsetzt. Sie braucht außerdem eine stabile Verbindung mit mehr Bandbreite als Audio und einen Bildschirm, der groß genug ist, damit das Gesicht lesbar bleibt. Drei praktische Folgen:
- Das Budget pro Minute steigt. Ist das Trainingsbudget fest, reduziert Video die Zahl der verfügbaren Übungsminuten. Bei Fähigkeiten, die viele Wiederholungen brauchen, kann dieser Tausch gegen das Trainingsziel arbeiten.
- Nicht jeder Arbeitsplatz hat die Verbindung. Verkaufsflächen, Krankenstationen und Hotel-Backoffices haben oft schwaches WLAN. Eine Sprachsitzung übersteht eine schlechte Verbindung besser.
- Mobiles Üben spricht für Sprache. Lernende, die auf dem Handy während des Pendelns üben, haben von einer Audiositzung mehr als von einem kleinen Videofenster.
Eine vernünftige Regel: Sprache als Standard, Video für die Szenarien, in denen das Gesicht Teil der Fähigkeit ist.
Entscheidungstabelle: Video-Persona oder reine Sprache
| Rolle | Echter Kontakt | Empfehlung | Warum |
|---|---|---|---|
| Telefonverkauf, SDR | Telefon | Reine Sprache | Der Job ist eine Stimme |
| Inbound-Callcenter | Telefon, Chat | Reine Sprache | Auf den Ton hören ist die Kernfähigkeit |
| Verkäufer im Einzelhandel | Von Angesicht zu Angesicht | Video für Begrüßung und Bedarfsermittlung, Sprache für Produktwissen-Übungen | Beobachtet werden gehört zur Verkaufsfläche |
| Hotelrezeption | Von Angesicht zu Angesicht | Video | Der Ausdruck unter Druck ist der Service |
| Außendienst, Account Manager | Gemischt, meist Termine | Video für die Probe des Termins, Sprache für die Vorbereitung von Telefonaten | Passend zur nächsten echten Interaktion |
| Arzt, Pflegekraft | Von Angesicht zu Angesicht | Video für schwierige Gespräche | Den Patienten beobachten ist eine klinische Fähigkeit |
| Personalbereich, einstellende Führungskraft | Von Angesicht zu Angesicht oder Videocall | Video | Eine Pause halten, während jemand nachdenkt |
| Technischer Support, Hotline | Telefon | Reine Sprache | Kein visueller Kanal bei der Arbeit |
| Führungskraft, die Feedback gibt | Von Angesicht zu Angesicht | Video für die schwierigsten Gespräche, Sprache für Wiederholungen | Wiederholungen brauchen Menge, die Generalprobe braucht Realismus |
Das Muster: Sprache für die Menge, Video für die Generalprobe eines Gesprächs von Angesicht zu Angesicht.
So funktioniert der Live-Avatar auf Replio
Bei Replio üben Lernende Gespräche laut, per Sprache, mit KI-Personas: einem Käufer, einem Kunden, einem Patienten, einem Mitarbeiter oder einem Bewerber. Jede Persona trägt ein Szenario mit ihren Einwänden und dem Moment, in dem sie diese bringt, dem verdeckten Bedarf hinter jedem Einwand sowie einer Erfolgsbedingung und einer Misserfolgsbedingung. Die Persona bleibt die ganze Sitzung lang in ihrer Rolle.
Der Live-Avatar ist eine Option zusätzlich zu dieser Sprachsitzung. Ist er eingeschaltet, erscheint die Persona während des Gesprächs als Video-Avatar in Echtzeit. Sonst ändert sich an der Sitzung nichts: dieselbe Persona, dasselbe Szenario, dieselbe Bewertung. Eine abgeschlossene Sitzung gibt dem Lernenden einen Score und schriftliches Feedback zu diesem Gespräch, und Führungskräfte können die Sitzung prüfen, das vollständige Transkript lesen und eine eigene Bewertung ergänzen.
Damit lässt sich die Entscheidungstabelle in der Praxis leicht anwenden. Machen Sie die Wiederholungen per Sprache und schalten Sie den Avatar für die Szenarien ein, in denen das echte Gegenüber des Lernenden im Raum sein wird. Teams aus Kundenservice, Einzelhandel, Gesundheitswesen und Personalbereich können beides im selben Projekt mischen.
Der kostenlose Plan enthält einen Platz, ein Projekt und einmalig 15 Testminuten. Die Pläne für Teams finden Sie auf der Preisseite.
Häufige Fragen
Was ist KI-Avatar-Training?
Rollenspiel mit einer KI-Persona, die Sie in Echtzeit sehen und hören können. Der Lernende spricht, der Avatar antwortet und reagiert, und das Gespräch wird danach bewertet. Das unterscheidet sich von Avatar-Videogeneratoren, die Sprechervideos für E-Learning erzeugen und nicht antworten.
Ist Rollenspiel mit Video besser als Rollenspiel mit Sprache?
Nicht generell. Video bringt Wert, wenn der echte Job von Angesicht zu Angesicht stattfindet, etwa im Einzelhandel, in Patientengesprächen, im Personalbereich und in der Hotellerie. Für Telefonrollen passt reines Sprachtraining zum Job und trainiert das Zuhören besser.
Macht ein Avatar KI-Rollenspiel realistischer?
Er fügt das Gefühl hinzu, beobachtet zu werden, und etwas, das sich im Ausdruck der Persona lesen lässt. Die Forschung zu sozialer Präsenz seit Short, Williams und Christie 1976 deutet darauf hin, dass reichere Medien sich mehr wie das Zusammensein mit einer Person anfühlen, während spätere Arbeiten von Biocca und Kollegen zeigen, dass ein reagierender Partner einen großen Teil dieser Präsenz schon erzeugt, mit oder ohne Gesicht.
Was kostet KI-Avatar-Training im Vergleich zu Sprache?
Die Videoerzeugung setzt auf der Sprache auf, also kostet eine Videominute mehr als eine Sprachminute und braucht mehr Bandbreite. Die meisten Teams nutzen Sprache als Standard und den Avatar für die Generalprobe von Gesprächen von Angesicht zu Angesicht.
Verwandte Artikel
Was ist KI-Rollenspiel-Training? Ein Leitfaden
Beim KI-Rollenspiel-Training üben Lernende echte Gespräche mit einer KI-Persona und erhalten Feedback. So funktioniert es, hier liegen die Grenzen.
KI-Telefontraining: Testanrufe auf dem echten Telefon
KI-Telefontraining im Vergleich: Browser, App oder Anruf. Was Testanrufe auf dem Telefon schulen und wie ein Training mit Replio Call abläuft.
Callcenter-Schulung: ein 30-Tage-Programm
Callcenter-Schulung für neue Mitarbeiter: ein 30-Tage-Plan nach Wochen, ein Gesprächsaufbau, eine Checkliste und Kennzahlen vor dem Weihnachtsgeschäft.